Joongwon Chae

硕士研究生 · 清华大学深圳国际研究生院

Joongwon Chae 在明亮的室内植物中庭留影
中国深圳

简介

我目前是清华大学深圳国际研究生院硕士研究生。我的研究聚焦于免训练视觉推理,即在不更新底层模型参数的情况下选择并使用参考证据。

我围绕一个核心问题构建免训练视觉系统:冻结模型应保留、路由并信任哪些参考证据?

我的研究涵盖记忆构成、投影一致性筛选、持续学习路由与检索到提示分割。

代表性研究

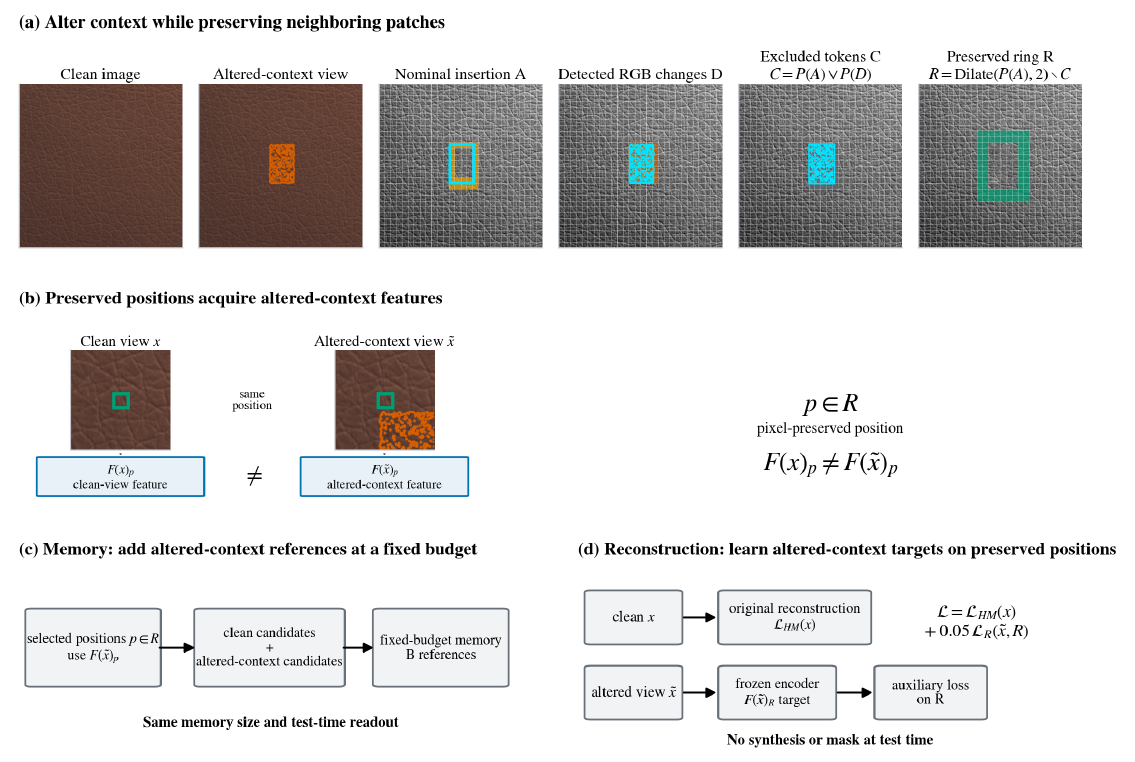
BoundarySupport 框架图,展示改变后的上下文、像素保持不变的邻近补丁、固定预算记忆与重建目标
BoundarySupport 改变周边语境,但只学习像素保持不变的邻近补丁。

ICLR 审稿中

What Remains Normal?

BoundarySupport:干净图像遗漏了有用的缺陷邻近正常补丁

核心主题
我检验仅由无缺陷图像构建的正常证据是否完整,重点关注真实缺陷附近仍保持像素正常但上下文发生变化的区域。
方法
我提出 BoundarySupport:通过可控合成缺陷改变周边语境,排除实际发生像素变化的 token,仅将像素保持不变的邻域特征用作固定预算记忆参照或重建目标。
核心算法
我排除与名义插入区域或任何检测到的 RGB 变化相交的 token,仅保留两个 token 范围内像素不变的环带,并将其改变上下文后的特征作为正常证据。
结果
在固定记忆容量下,缺陷邻近正常补丁将 MVTec P-AP 从 73.34 提升至 76.95,其中两个 token 范围内的邻近区域恢复了 94.70% 的增益。经过三个配对随机种子,BoundarySupport 在全部六个记忆与重建设置中均提升 P-AP。
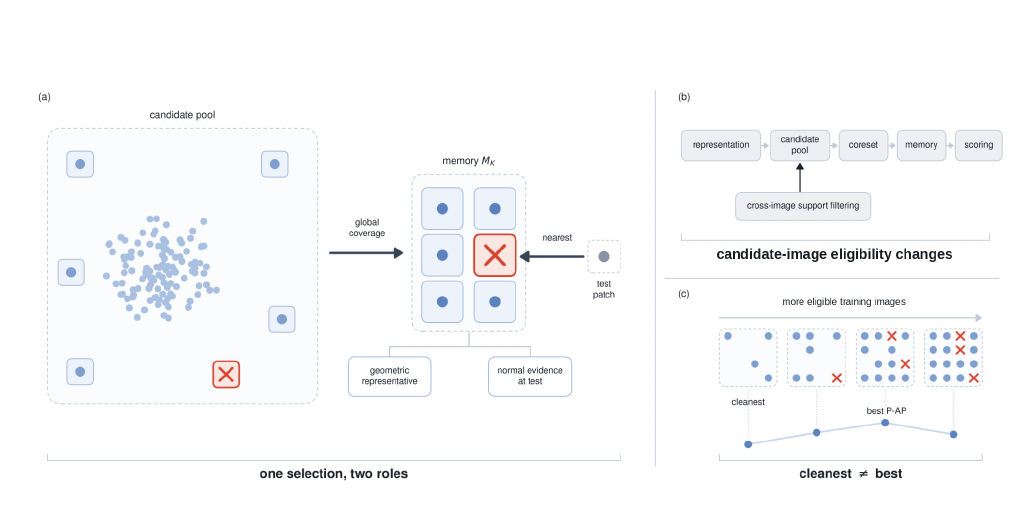
CLEANCON 原理图,将候选图像资格与固定的全局记忆构建器分离
CLEANCON 将候选资格与固定记忆构建器分离,以检验为何最干净的记忆并不总是最佳。

ICLR 审稿中

What Memory Composition Does Not Tell Us

CLEANCON:记忆纯度与记忆效用并不相同

核心主题
我研究覆盖驱动的记忆选择如何将稀疏污染直接放大为推理阶段的正常参照,并检验更干净的记忆是否真的更好。
方法
我提出 CLEANCON,一种袋外跨图像支持门控方法。它只改变候选图像资格,同时保持编码器、绝对记忆容量、构建器与推理规则不变。
核心算法
我根据 20 个袋外支持库计算逐补丁软投影残差,以残差最高的 0.5% 补丁为图像评分依据,再对支持库取中位数、对特征深度取均值,并将风险较低的一半图像交给保持不变的记忆构建器。
结果
在 1% 记忆预算下,全局最远优先选择将稀疏污染放大 16.04 至 40.61 倍。CLEANCON 将最终记忆污染率降至近零,并在全部 12 个匹配比较中提升类别宏平均 P-AP;但最干净的记忆并非性能最高。
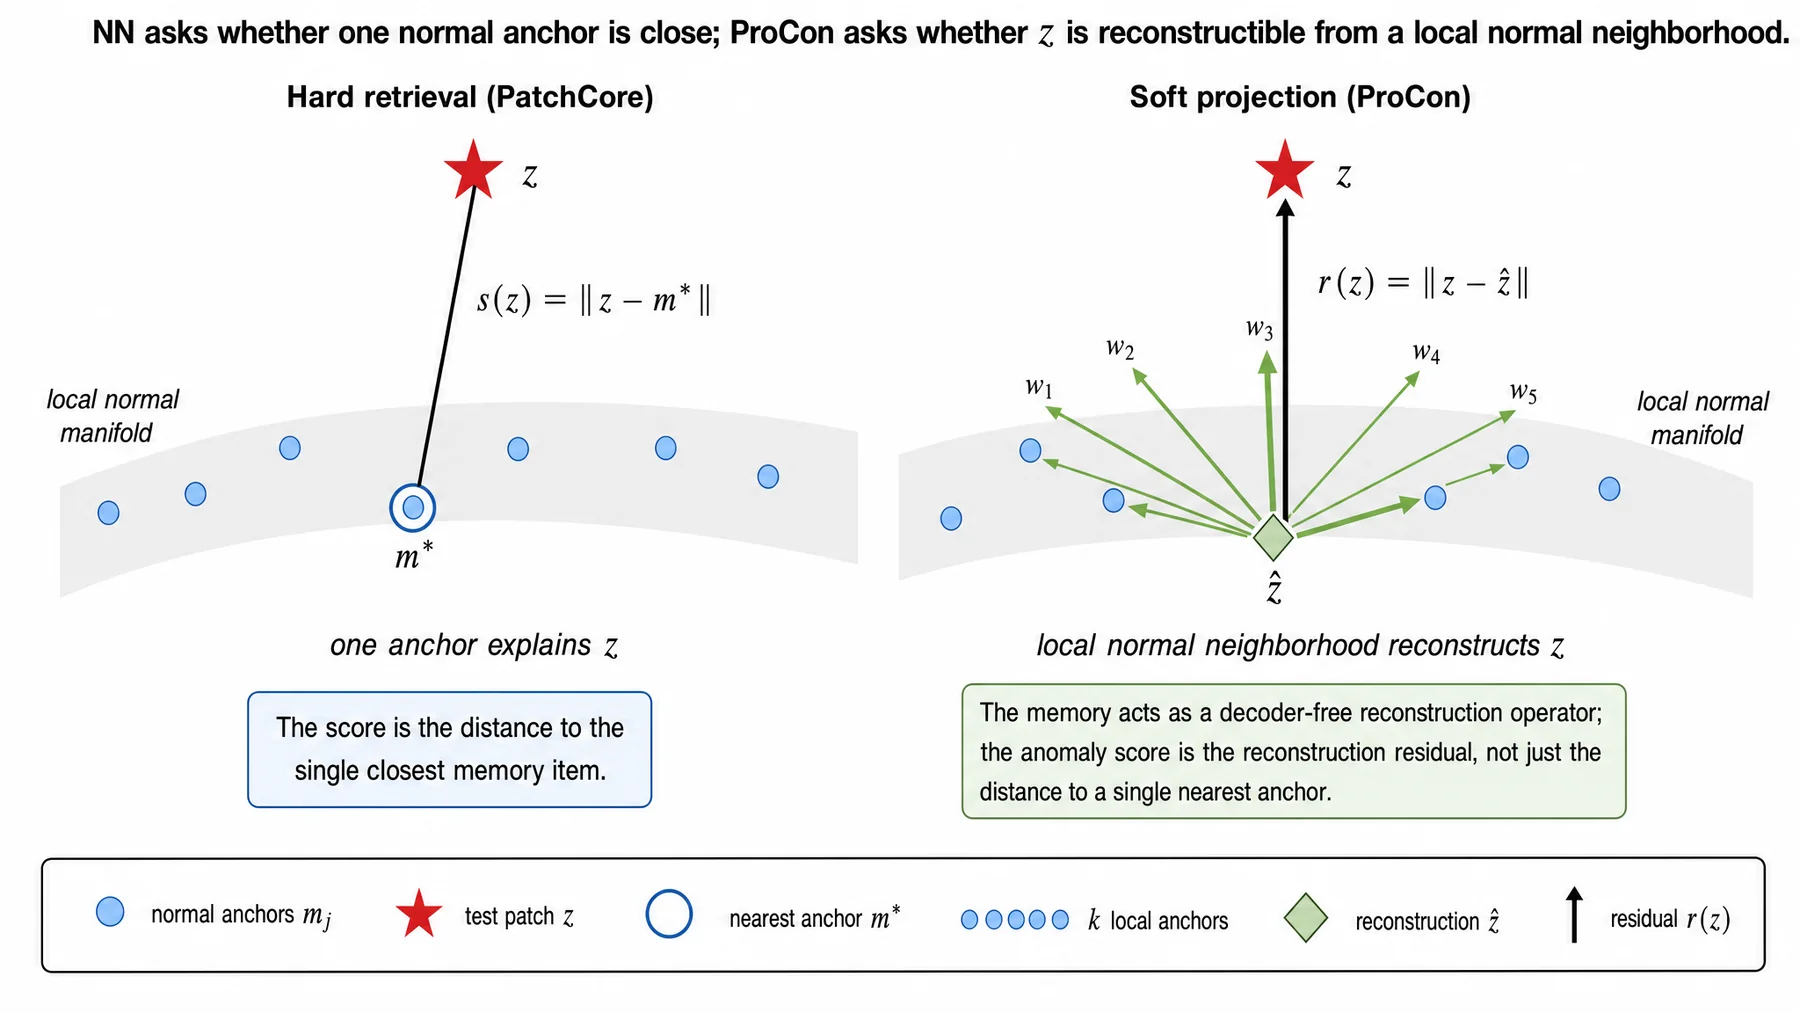
ProCon 方法图,对比硬最近邻检索与软局部投影
ProCon 以局部投影取代单一最近邻锚点。

审稿中

ProCon

面向免训练异常检测的投影一致性记忆

核心主题
我研究冻结异常检测器如何依据内部一致性而非单纯最近邻覆盖来筛选有用的参考记忆。
方法
我提出 ProCon,一种免训练、无需解码器的重建框架,以正常记忆上的软投影取代硬最近邻检索。
核心算法
我将每个测试补丁软投影到局部正常邻域,对随机种子扰动的多组记忆残差取中位数,再对不同特征深度的残差图取均值。
结果
在冻结骨干网络条件下,我们在 MVTec AD、VisA 和 Real-IAD 上分别取得 99.8%、99.2% 和 93.2% 的图像级 AUROC。
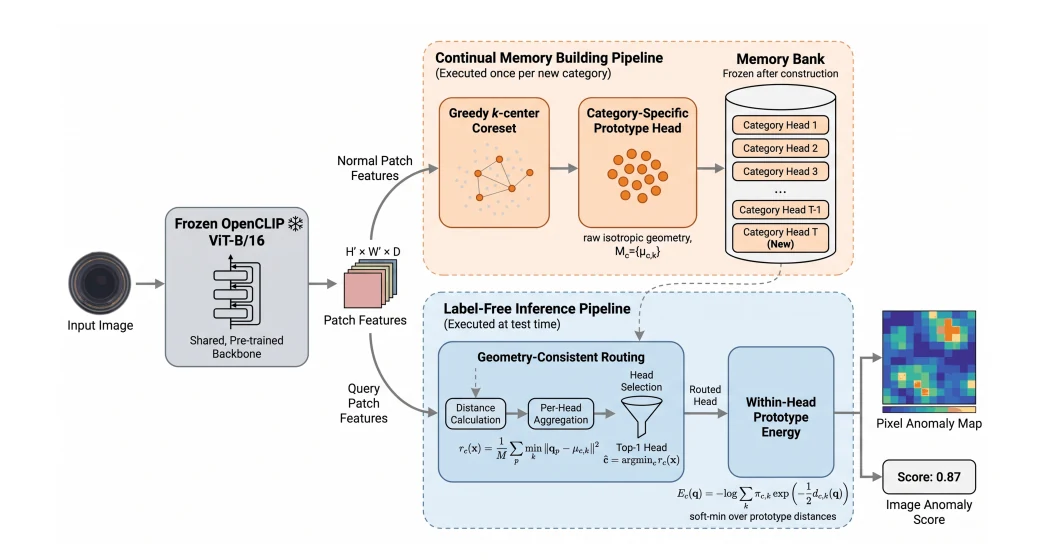
GCR 流程图,包含冻结的 OpenCLIP 特征、类别原型库、几何一致路由与异常评分
GCR 将跨检测头路由与头内异常评分分离。

审稿中

GCR

面向任务无关持续异常检测的几何一致路由

核心主题
我研究在未知任务身份的情况下,任务无关持续检测器如何将每个测试图像路由到正确的冻结检测头。
方法
我提出几何一致路由,将跨检测头的原型几何与头内异常评分分离,使新任务能够在不重训练旧检测头的情况下加入。
核心算法
我在共享冻结空间中,以 32 个采样补丁到各类别原型库的平均最近距离完成路由,再仅在选中的检测头内计算 LogSumExp 异常能量。
结果
在 MVTec AD 与 VisA 上,我们验证了 GCR 无需端到端表征学习即可显著提升路由稳定性,并将遗忘保持在接近零的水平。
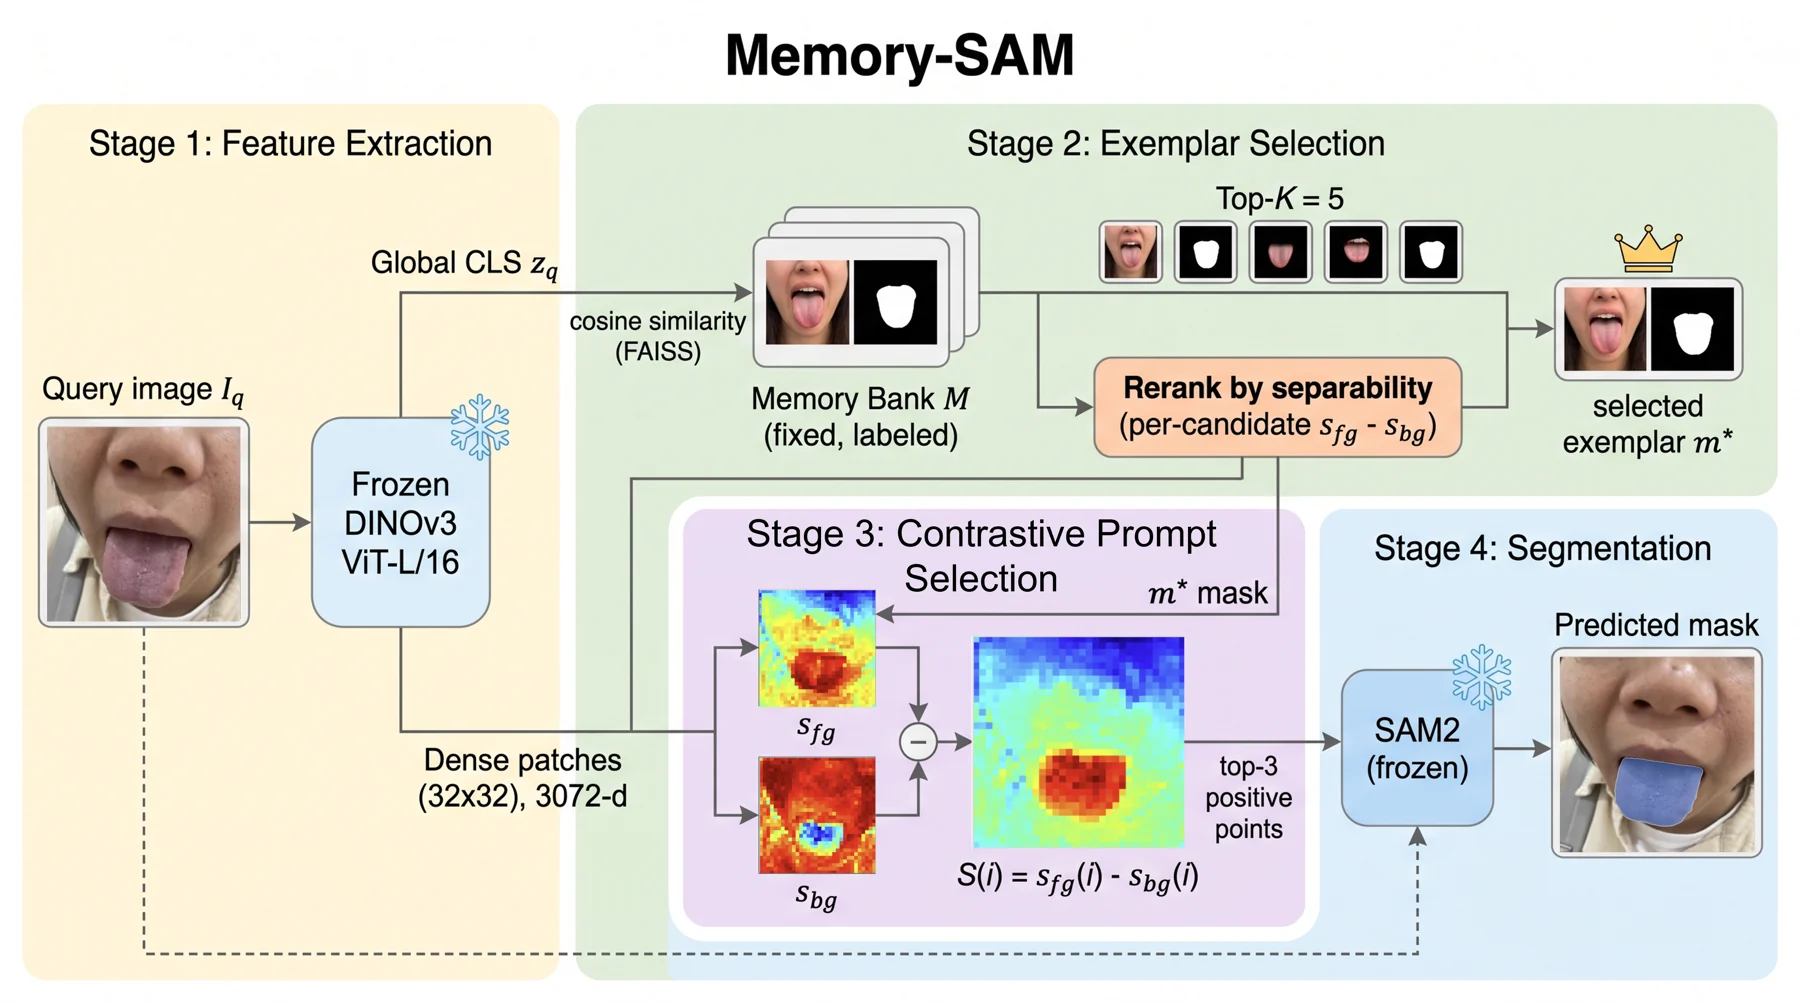
Memory-SAM 架构图,展示样例检索、对比点选择与 SAM2 舌体分割
Memory-SAM 将 DINOv3 前景与背景对比转化为自动 SAM2 点提示。

AAAI 2027 审稿中

Memory-SAM

通过检索到提示实现无需人工提示的舌体分割

核心主题
我研究如何利用小规模标注记忆,在受控环境与非受控舌图像中自动生成可靠的 SAM2 提示,全程无需人工点击或参数更新。
方法
我用冻结的 DINOv3 检索候选样例,以专家掩码划分其前景与背景特征,再根据查询图像上的前景背景可分性完成重排序。
核心算法
我计算 DINOv3 前景与背景相似度之差 S(i) = s_fg(i) - s_bg(i),选出前三个前景对比点,并将其作为 SAM2 提示。
结果
我们在 HIT-Tongue 与包含 2,155 张智能手机图像的 SM-Tongue 上分别取得 0.984 和 0.973 mIoU,并公开 2,155 对去标识化的 512 x 512 图像与掩码。此前版本在 ICASSP 2026 与 MICCAI 2026 的平均审稿评分分别为 24/28 和 4.0/5.0。

近期论文

学术经历

经历

  • 硕士研究生清华大学深圳国际研究生院2024年至今
  • 研究实习生Ratel Soft2025年7月至今

教育

  • 清华大学深圳国际研究生院2024-2027(预计)电子信息硕士(生物医学工程方向),生物医药与健康工程研究院。导师:Peiwu Qin、Runming Wang。
  • 上海交通大学自动化系2018-2024自动化专业学士。

荣誉与奖学金

  • 清华大学国际学生优秀学生奖学金一等奖,2024
  • 清华大学生物医药与健康工程研究院英才一等奖学金,2025
  • 清华大学国际研究生学费奖学金,2025-2026
  • 深圳大运留学基金会奖学金,2026

语言能力

韩语(母语);英语(IELTS 6.5);中文(HSK 6);日语(JLPT N2)。